PlugRL
PlugRL 让策略对着跑在别处的环境训练:另一个进程、另一台机器、一台没有 GPU 的机器, 或者一个不是用 Python 写的程序。训练端持有策略和算法;环境端步进环境,向它请求动作。 两者之间是一份写下来的协议,它不只把动作送出去,也把奖励和回合结束传回来,所以策略 是在被训练,而不只是被调用。
在它上面能跑什么
两个 MLP 策略和两个算法在四个任务上的全部组合,加上作为对照基线的高斯 MLP + PPO。 十六格全部学会。边框和上面的标签写的是实验得出的结论。每段视频下面那条线是三个种子的 训练曲线(画的是回报;方块那一列画的是成功率,因为那几组的奖励口径不一样),同一列用 同一个纵轴,所以平的线就是真的没动。鼠标悬停就能播放;点一下格子,除了播放,还会在 下面显示训练它的那两条命令。从一格换到另一格,变的只有指定策略、算法和任务的那几个词。
方块任务上,每一行都是从预训练好的策略起步微调:dppo-policy 和高斯 MLP 用的是
DPPO 官方发布的存档,fpo-policy 用的是我们自己行为克隆出来的起点
(E35)。
高斯 MLP 这一行,在三个 MuJoCo 任务上是 CleanRL 的策略和 PPO,回报和 CleanRL 自己
报告的差不多(E38);
在方块任务上是 DPPO 的高斯 MLP,用 DPPO 自己的 PPO 设置微调
(E40)。
表里没有 dppo-policy · FPO,因为这个组合不存在:FPO 只能训练流策略。每段视频都取自
三个种子里最后十轮居中的那个种子的最终检查点。这个检查点评估了五个回合,放出来的是回报
居中的那一回合,不是最好的那一回合。生成这些内容的脚本在
figures/coverage。
训练端和环境端连 Python 环境都不共用。训练这些格子的服务端,没有一台装了 MuJoCo、 robosuite 或 gymnasium。环境客户端分别跑在两套独立的环境里:MuJoCo 那几个任务用的是 gymnasium 加 MuJoCo 3;robomimic 用的是 robosuite 1.4.1 加 MuJoCo 2.3.7,因为 robosuite 1.4.1 在 MuJoCo 3 上跑不起来。训练这十六格的是同一个服务端代码库。
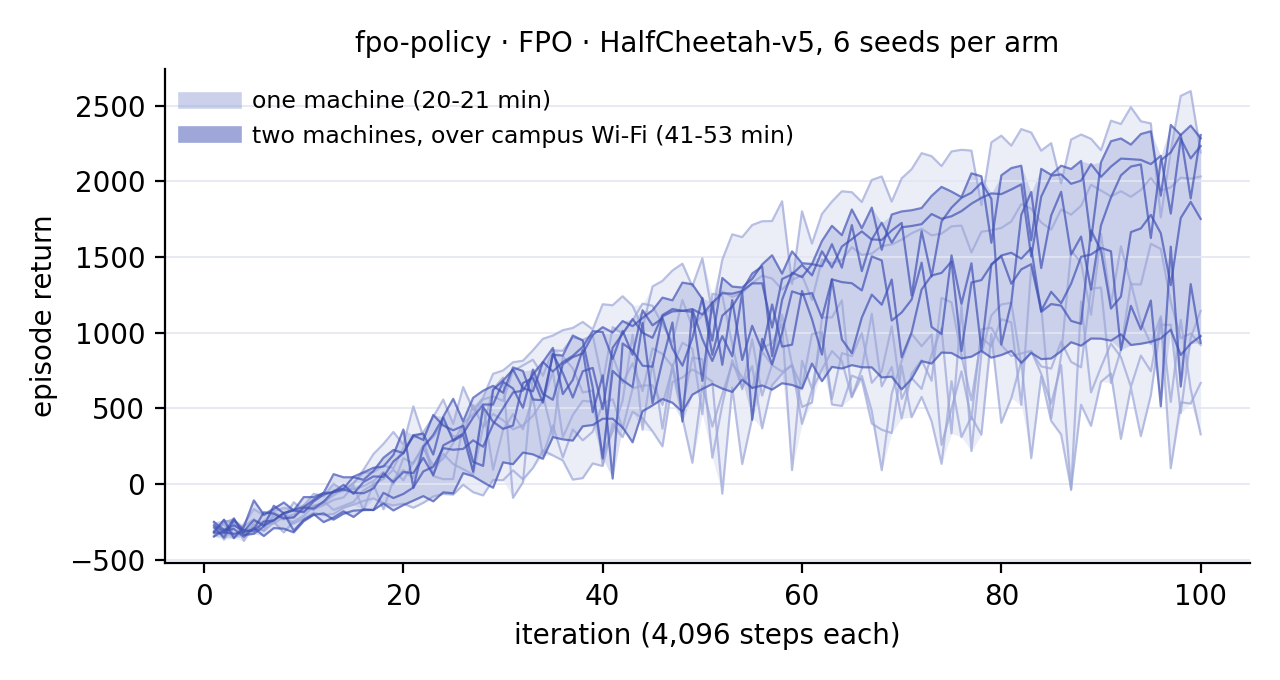
同样这一对,把环境端放到另一台机器上也照样学会:一台连着校园 Wi-Fi 的 Windows 笔记本步进 HalfCheetah,训练端在一台 Linux 工作站上。两边各六个种子落在同一条带子里;跨两台机器时一次 训练用了 41 到 53 分钟,同一台机器上是 20 分钟(E43)。
环境端很轻
训练端有 6.5G,而且要一张显卡;跑环境的那台机器两样都不需要。LIBERO 环境端可以装成 3.4G、零个 nvidia wheel(原本是 7.8G 带十六个),发出的观测逐字节相同,并且能在 CPU 上渲染:十个客户端同时跑,30 个回合全部成功,墙钟是用显卡时的 1.91 倍 (E12、 E13)。 软件渲染的单步慢 10 倍,其中大部分被"多个客户端排队等同一个策略"的等待掩盖了。
和其他"通过通道训练"的系统比,它也更轻。plugrl-env-client 装 31 个包、222 MB,
不带 torch;下面那个 C++ 客户端是一个 86 KB 的可执行文件。RLlib 的 external env 客户端
和 LeRobot 的 HIL-SERL actor 各装约 6.1 GB,其中有 torch 和 15 个 CUDA 包,因为它们都在
环境端跑策略。光是环境端轻并不新鲜:dm_env_rpc 和 openpi 的客户端更小,但两者都不通过
自己的通道训练(E45)。
环境端也不必是 Python。协议是写下来的,附带一致性检查器。一个 除了标准库之外什么都不用的 C++ 程序(没有 msgpack 库,也没有 WebSocket 库),自己实现了 Pendulum,通过 PlugRL 训练出了策略,学得和 Python 环境端一样好 (E44)。
别的训练框架也能通过它训练
协议不绑定 PlugRL 自己的训练端。几个小适配器把它包装成训练框架本来就认的环境接口
(plugrl-bridges)。通过它们,三个不是为 PlugRL 写的训练框架训练 PlugRL
的环境端,每种组合的每个种子都学会了:
- RLinf 的 PPO,训练 C++ Pendulum 客户端;
- Stable-Baselines3 的 PPO,训练 C++ Pendulum 客户端和 HalfCheetah;
- CleanRL 的 PPO,训练 HalfCheetah
(E49)。
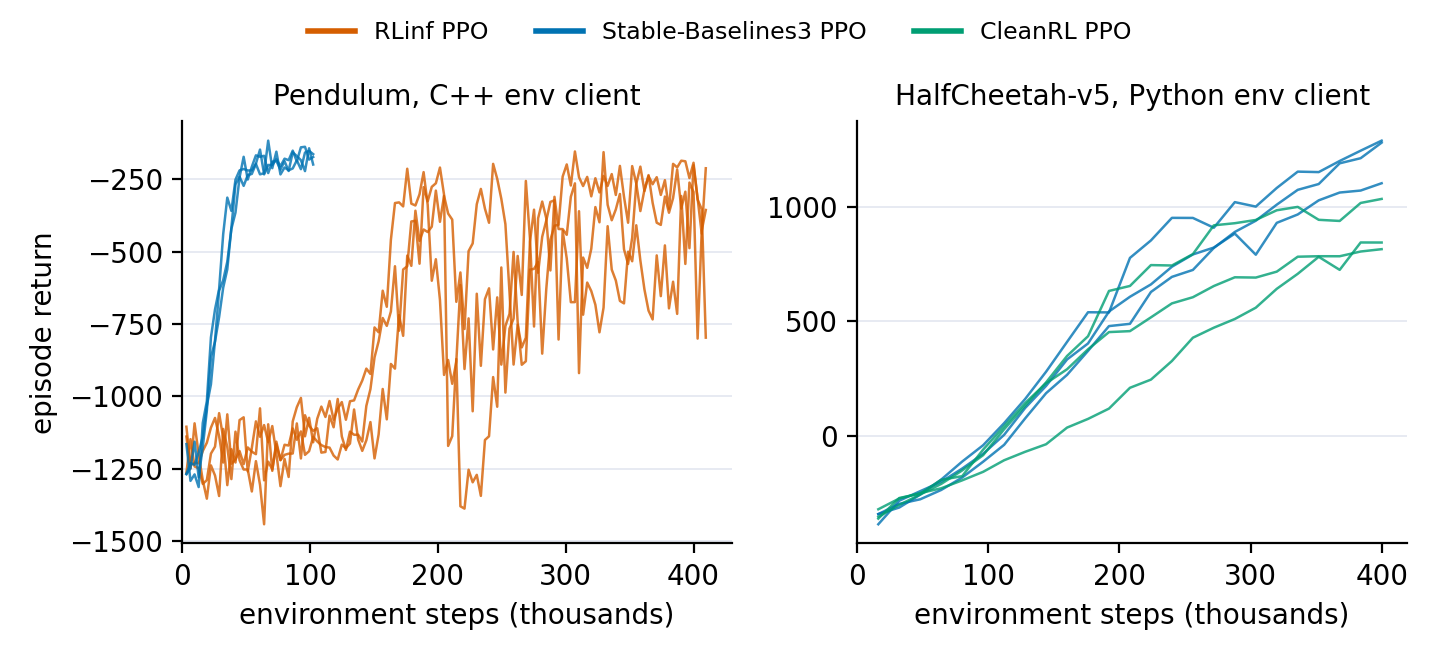
每条线是一个种子在 16 个环境端上的平均回报,数据来自 bridge 自己记的回合日志。同样的 设置下,RLinf 学会 Pendulum 比 Stable-Baselines3 晚;E49 记录了这一点,但没有解释原因。
RLinf 还训练了跑在一台笔记本上的 16 个 HalfCheetah 环境端,那台笔记本没装 torch、Ray 和 RLinf,环境端只占 276 MB (E48)。
隔着协议,训练看到的东西没有任何不同。Stable-Baselines3 把 16 个环境放到另一个进程里, 最后的权重和环境放在自己进程里时逐字节相同:Pendulum 和 HalfCheetah 上如此 (E50), 换成 Atari 画面加 CNN 也如此 (E53), 两端之间每个字节每个方向都压住 25 毫秒还是如此 (E52)。 变的只有时间:同一台机器上 16 个环境每步多 0.4 到 0.6 毫秒,每步带 16 帧画面时多 2.6 到 3.0 毫秒,链路慢时每步大约多两个单程延迟。
边界出错时,什么都不会报错
67 秒,无声:一个值在送往训练端的路上被改掉,学习曲线照样上升,步账本找到了这处改动。
借同一个 bridge,我们还能看边界出错时会有什么表现。Stable-Baselines3 的 PPO 训练 Pendulum、HalfCheetah、Hopper 和 7 关节机械臂 Pusher 时,环境端把发出去的某一个字段按 某一种方式改掉:观测、动作、奖励或回合最后一帧观测被置零、换成上一步的、换成下一个环境的, 或者经过 float16 舍入;凭空多出一个回合结束,或者把回合结束的类型发错;跳过一步。没有任何 报错。除非每个值都错了,我们原来依赖的学习曲线阈值最多只抓到十分之一的运行,和十个无错 种子比较的检查最多抓到 21% (E54、 E56、 E58)。 在干净的环境里评估每个最终策略,结论和曲线一样:两项曲线检查都通过的 728 个边界出错运行中, 723 个和无错种子表现相当 (E57)。 但这些运行已经不是原来那次运行了:几乎全都停在了不同的权重上,奖励出错时训练端记下的回报 也变了。
能看到每一处错误的,是检查运行本身。步账本在边界两侧各记一份:每个环境收到了什么、给出了
什么,训练端发出了什么、收到了什么,然后逐步比对。单机上,它在 Pendulum、Hopper 和 Pusher
上抓到并定位了全部 585 个边界出错的运行;跨两台机器时,抓到了 Pendulum 上全部 21 个。全程
不需要无错运行做参照,在 Pendulum 上训练时间的中位数只多 3%
(E55;
Hopper 和 Pusher 见 E56、E58)。在环境端记的回合记录,抓到了故意埋进训练端日志里的错误。
这类错误在实验之外也会发生:Gymnasium 1.3 的向量回合统计在 SAME_STEP 自动重置下,每个
环境从第二个回合起都会丢掉回合的第一个奖励,直到 1.4 才修好
(E51)。
步账本现在单独做成了一个包 step-ledger,Gymnasium
和 Stable-Baselines3 都能用,用不用 PlugRL 都行。给每个环境包一层 LedgerEnv,给训练端看到的
向量环境包一层 LedgerVectorEnv(Stable-Baselines3 用 LedgerVecEnv);跑完后
stepledger compare 会指出第一处不一致在哪个环境、哪个回合、哪一步、哪个字段。每一侧每个环境步
只多几微秒。
这部分内容是论文 Detecting Silent Faults at the Environment-Trainer Boundary in Reinforcement Learning,已被 CoRL 2026 Workshop on Everything Beneath the Policy 录用 (PDF;引用方式)。
拆开的代价
同一台机器上几乎没有代价:只传状态时一次交换 0.1 毫秒,观测有 588 KiB 也不到 1 毫秒。
跨两台机器时,代价分成两项:
- 固定延迟:Wi-Fi 上的笔记本经 Tailscale 连工作站,大约 3 毫秒。
- 观测数据量除以链路带宽,只算一次:结束一段动作的反馈里带着观测;有了
reuse-feedback-obs(训练端提供、环境端默认使用的协议特性),下一次请求动作时不再
重复发送。
在一条 23.7 MB/s 的链路上,只传状态的任务每步多约 3 毫秒,一个 184 KiB 的相机观测每步多 11.6 毫秒,观测传两次时是 18.5 毫秒。两种情况下训练出的权重逐字节相同 (E46; 第一版的测量见 E43)。 链路越快,第二项按比例越小。
真实 VLA,端到端
画面是未经微调的 pi0.5 通过这条边界在 libero_spatial 任务 0 上的执行过程——
三个回合,全部成功。这是策略自己看到的观测流,原生 224×224,不是外部机位。
同样的两个进程也能承载一个完整尺寸的 pi0.5:环境端步进 LIBERO,服务端返回动作。边界
本身没有任何改动,变的只是策略。未经微调的 checkpoint 在 libero_spatial 上 99/100、
在 libero_10 上 185/200,与 openpi 公布的 98.8 与 92.4 一致;而且服务端记录的回合数
与步数和客户端逐一相等——正是这一条说明传输层没有悄悄丢掉任何东西
(E11)。
用 PlugRL 对 pi0.5 做强化学习微调,目前还没能让它变好。这部分记录和视频在 单独一页。
快速开始
下面这一对不需要 GPU 就能学会:FPO + HalfCheetah-v5,纯 CPU,不需要下载任何资源文件。 两个包都不在 PyPI 上,先从源码安装:
git clone https://github.com/PlugRL/plugrl-server.git
git clone https://github.com/PlugRL/plugrl-env-client.git

cd plugrl-server     && uv sync && cd ..
cd plugrl-env-client && uv sync --extra mujoco && cd ..
然后开两个终端,各自进到对应的仓库里运行(uv run 用的是那个仓库自己的 .venv):
# 终端 1,在 plugrl-server 里 —— 训练端
uv run plugrl-run-server fpo-policy default fpo default \
    --port 8000 --policy.device cpu \
    --algo.global-steps 500000 --algo.buffer-size 4096

# 终端 2,在 plugrl-env-client 里 —— 环境端
uv run plugrl-run-env-client mujoco-v1 \
    --server-host 127.0.0.1 --server-port 8000 \
    --num-envs 1 --num-episodes 600 --runner.replan-steps 1 --runner.seed 0
episode 回报从 -300 附近起步,三个随机种子到 50 万步达到 1928 ± 224,在做这次测量
的纯 CPU 机器上大约一百分钟
(E6)。
其余内容在快速开始:为什么 --algo.buffer-size 不能省、
怎么只检查连通性、以及常见问题。
组件
plugrl-server:训练端,负责算法、策略、checkpoint、指标追踪plugrl-env-client:环境端,负责创建环境并采集 rolloutplugrl-protocol:协议与序列化层,WebSocket 与 msgpack
环境、策略和算法都可以放在你自己的包里,只要在使用它的那一端 import 并完成注册。
下一步
引用
如果边界检查对你有用,请引用这篇论文: